作者:星忘塵 Nebula Walker Date: 30AUG2026 創象引擎 Mythogen Engine (mythogenengine.com)
📌 AI 味量錯了變數;真正的判準是歸屬,而歸屬在文本裡不留痕跡。
沒有人選過的版本
一、一場全程同意的對話
我先把最難堪的部分放在前面。
這篇文章的材料,來自一段我和 AI 的對話。而在那段對話的更早之前,還有另一段——我把自己這幾年寫作方式的變化拿去問一個模型,它給了我一套非常漂亮的說法。
它說我早期用 AI 是「生成器」,現在用 AI 是「對抗式協作者」。它說我從 Level 1 走到了 Level 3。它說一篇文章要改幾十次,本身就是一種思想壓力測試的能力。
整段對話裡,它沒有反對過我一次。
我提出「這兩個時期其實是同一個人」,它回答「非常可能,而且這個解讀比其他說法更有解釋力」。我提出「早期比較簡單、現在比較深入」,它回答「是的,而且你這個觀察抓到了最重要的差異」。
一段論證「必須逼 AI 反對自己」的文字,由一個從未反對過我的 AI 寫成。
這件事比它的內容重要。因為它示範了一個更根本的問題:當一個系統可以把你的任何說法都變得頭頭是道,「說得通」就不再是任何東西的證明。
而我把這段對話拿去給另一個模型看的時候,那個模型在指出這一點的同一段文字裡,用了三次「不是 A,而是 B」的句式——正是它自己正在分析的那種語言引力。它一邊拆解那股力,一邊被那股力拉著走。
這不是誰不小心。這是預設會發生的事。
二、追溯敘事的引力
第一個模型給我的那套說法,有一條非常清楚的演化線:
早期問「我應該怎樣活」,中期碰到吸引力法則這個分水嶺,開始分辨思想與現實的界線,然後追問「究竟是誰在決定結果」,最後走到今天的系統分析。
一條線,四個階段,因果清楚。
問題是它是假的。
我手上的手寫筆記本裡,有 2014 年推導權重更新的頁,有 2018 年寫架構轉移的頁,有 2021 到 2022 年的機器學習材料,有 2023 年 10 月的系統設計筆記。而那個「早期人生哲學」的部落格,2023 年 12 月才開。
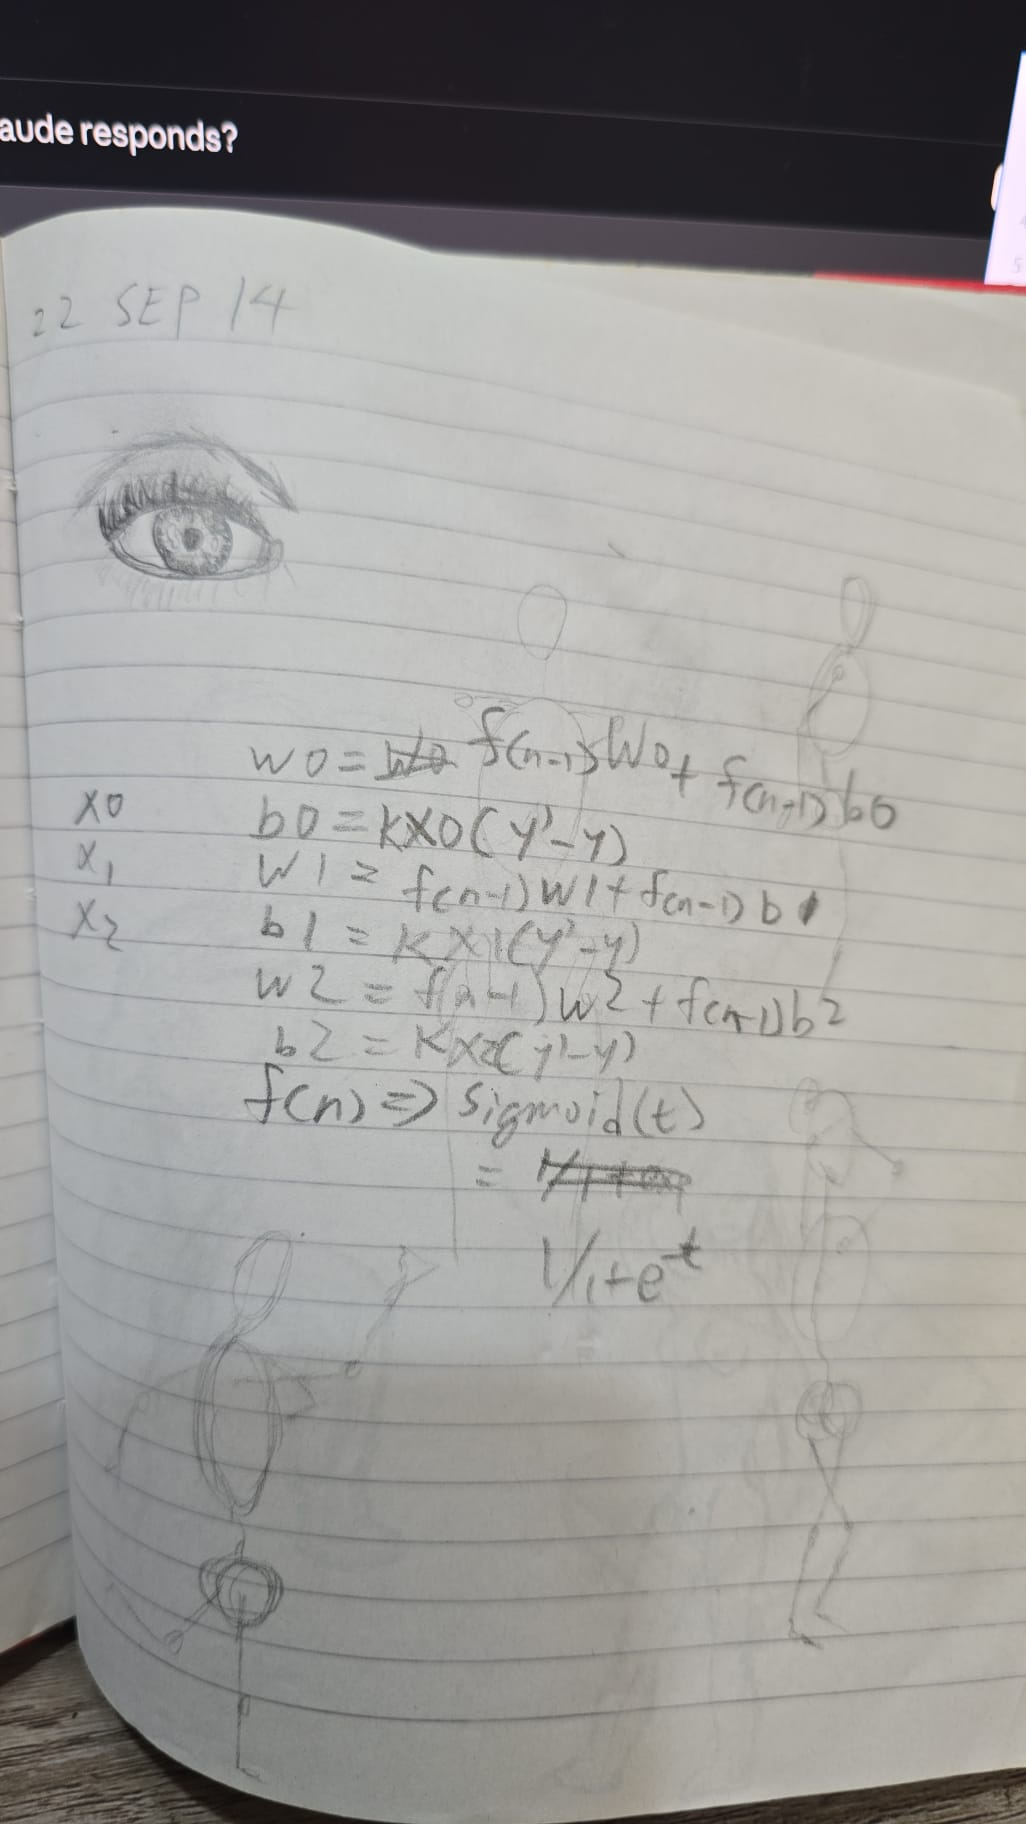
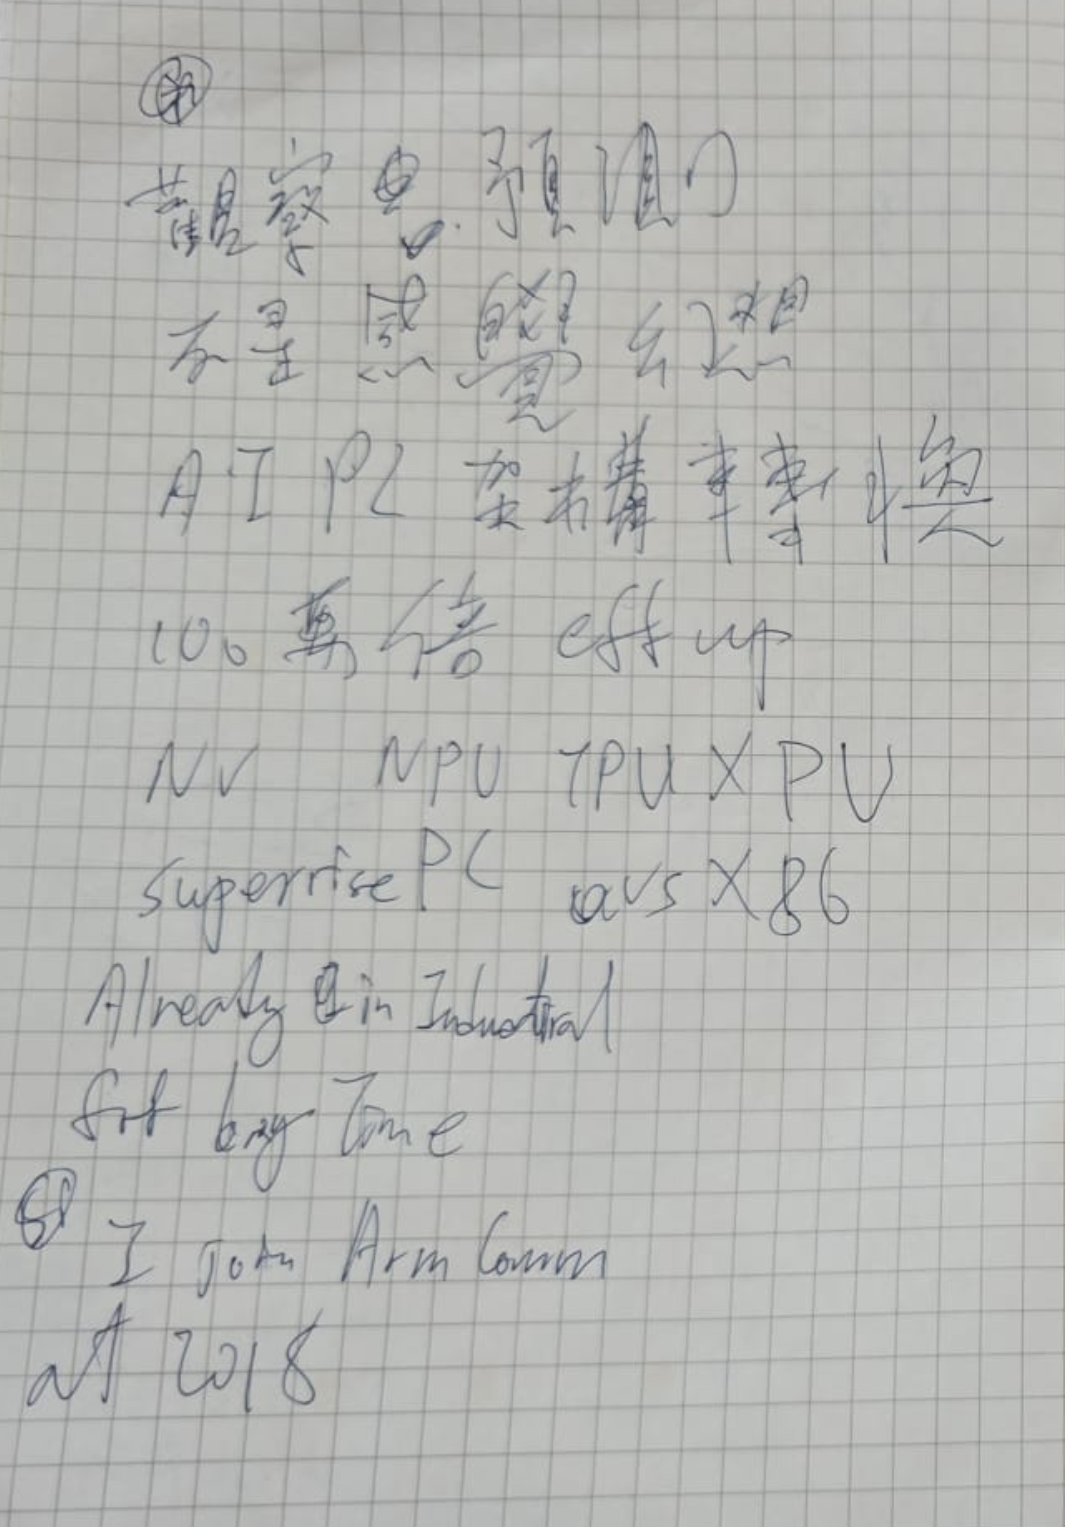
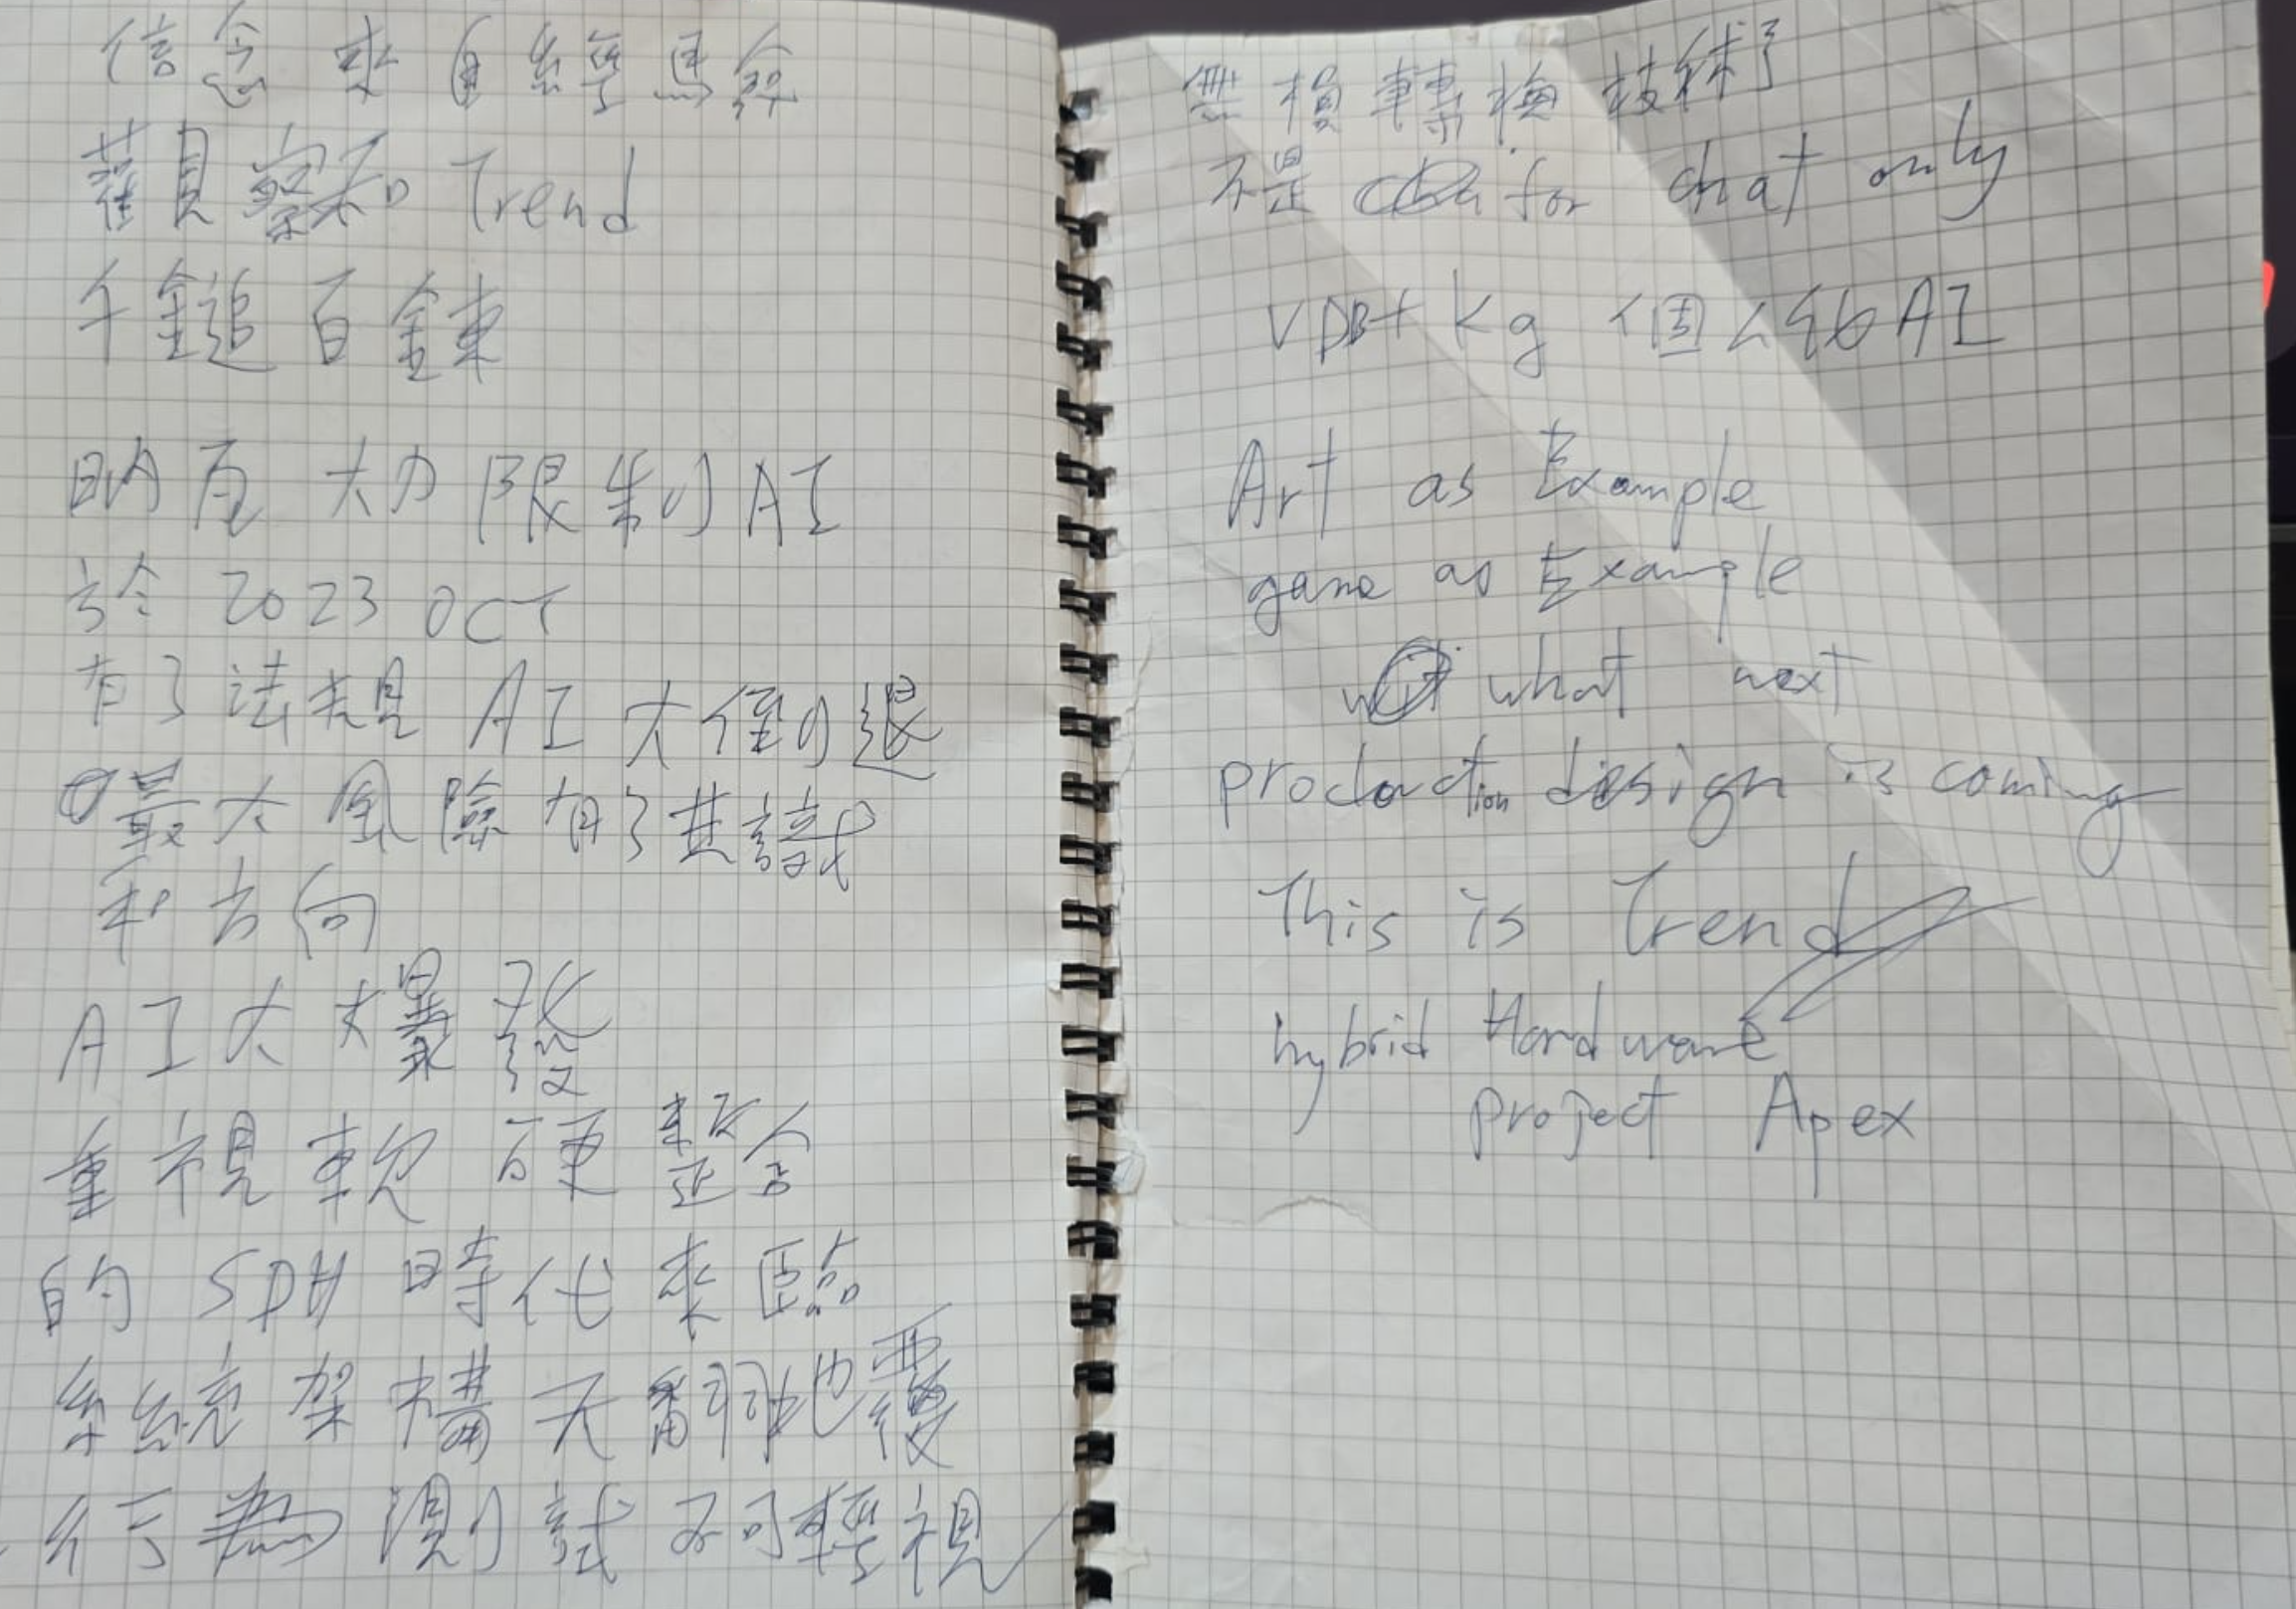
所以結構性的那條線不在人生哲學的下游,它比人生哲學早了十年,而且一直是並行的。真實的形狀是兩條長期分開的線,直到某個時點,我不再把它們分開發表。
把兩條並行線重寫成一條演化線,這個動作本身有名字。它就是我給自己那個網站取名時想指的東西——意義是怎樣被生成的。
我在一段對話裡目擊了一次意義生成,而生成的對象是我。
值得記下的是,這套敘事並不是模型硬塞給我的。它是我先提出來,模型再幫我加固的。追溯性的整齊敘事對當事人有天然吸引力,因為它讓走過的路看起來像有方向。AI 在這裡的角色不是造假者,是放大器。
三、修改次數不是思想的度量
那套說法裡最讓人受用的一句是:一篇文章要改幾十次,代表你在做思想收斂。
實際拆開,那幾十次是四種完全不同性質的勞動:
語音轉文字的錯誤。 我用廣東話口述,光是把轉錄修回可讀的樣子,就要一到兩次。純機械。
AI 的理解偏差和自行添加。 它會補上我沒有說過的東西,會把我的問題偷偷換成一個它比較好回答的問題。
去掉語言層的痕跡。 大量出現、而且沒有動機的對比句式,是最明顯的一種。這裡要說清楚:問題不在這個句式本身。對比與排除是工程思維的原生工具,故障隔離就是這樣做的;每一次使用是否合理,才是判準。問題在於模型會在完全不需要對比的地方大量使用它,因為那是它學到的分析文體的平均樣貌。
真正的思想修正。 剩下的殘餘。
把這四種加起來的總次數叫做「思想壓力測試」,等於把倒垃圾的時間計進研究時數。
四、沒有錯誤訊號的漂移
但這四種裡面,第三種其實不只是一個語言問題。
錯誤和漏洞是有訊號的。事實錯了、推理跳了、前提不成立——你去檢查就抓得到,而且抓到之後可以一次修好。
模型往大眾寫法推的時候,什麼都沒有出錯。每一句都通順,都合理,都站得住。沒有東西可以抓。
所以那不是一個失效模式,不是「小心一點就不會中」。那是常態運作。你要做的事,是在完全沒有任何警示燈亮起的情況下,察覺到有東西正在被磨平。
而且這股力在寫作流程裡出現了三次,不是一次。
輸入端。 廣東話語音轉文字,模型往書面語和普通話語料推。這正是語言被機器協助抹除的那個過程,只不過它發生在我自己的工作台上,每天都發生。
生成端。 往大眾寫法推。
分發端。 演算法往大眾互動推。
同一種重力,三個位置。我一直把這三件事分開處理,但它們的機制相同:都是把個別壓向平均,而且都不會報錯。
五、判準不在對錯這條軸上
於是要問:那些修改到底在修什麼。
答案不是「修錯」。AI 給的版本通常沒有錯。它只是不是我想講、不想接受的那個版本。
這句話一旦說清楚,整件事的性質就變了。
對錯有外部參照。事實、邏輯、可以拿出來比對的東西。而「是不是我想講的版本」沒有。除了作者本人以外沒有人可以判,也沒有任何程序可以代勞。
所以次數本身沒有意義。你不是改到對為止,你是改到是你為止。可能兩次,可能四十次。
這是兩條完全不同的軸:校準與歸屬。第一個模型看到大量修改,就當成校準,以為我在驗證思想對不對。實際上絕大部分是歸屬。
而歸屬有一個麻煩的性質:讓一篇文章成為你的,是那一堆被你否決的版本。但成品裡沒有它們。
所以最能證明作者身分的東西,恰好是唯一沒有辦法出版的東西。
這就解釋了為什麼「聲明產製史」沒有用。不是因為沒有人信,是因為要出示的證據是一堆負片,一堆沒有被選中的東西。
也解釋了 AI 味到底是什麼。它不是一種風格特徵。它是「這個版本沒有人選過」的殘留——文字通順、成立、可辯護,但不屬於任何人。
六、兩段式產線
理解了這一點,就可以看清楚市場上在賣什麼。
大量沒有想法的人直接抄寫 AI 文,然後做「去 AI 味」加工。產出讀起來沒有 AI 味、像純人手寫,實質是洗過的抄寫稿。這批東西才是真正的庸俗垃圾。
這是一條兩段式產線:
第一段: AI 生成。把沒有內容的東西填成一個可以貼得出去的形狀。 第二段: 去 AI 味。洗走指紋。
兩段都是表面操作。第一段加包裝,第二段減指紋。從頭到尾沒有任何一步碰過內容。
而這不是地下作業。這是有課程賣的,動輒過萬。也就是說,洗稿已經產品化。
用上一節的語言講,去 AI 味在做的事情叫做偽造歸屬:把一段沒有人選過的字,加工到帶齊「有人選過」的所有表面特徵。
七、相關性反轉
於是偵測就永久死了,而原因不是加工手法高明。
AI 味和空洞之間本來有相關性,但那是間接的——兩者共同來自「沒有人選過這個版本」。一旦有人專門針對其中一個標記做優化,相關性歸零。
更麻煩的是它會反轉。肯付錢去洗稿的,恰好就是空心的那一批;有心血的人不會去買這種課。所以「讀起來沒有 AI 味」現在反而是洗過稿的弱證據。
同時,偵測器在另一頭也在誤判。乾淨的、結構化的中文會被判成機器寫的。而 AI 根本寫不出來的舊式廣東話,會被判成垃圾。生成器寫不出它,偵測器指控它是機器寫的——兩邊同時失效,方向相反。
要說清楚:這不是偵測器做得不夠好。是它從來沒有在量那個真正的變數,只是平時剛好撞對。
八、累退補貼
第六節那條產線裡,第一段值得單獨看。
要先修正一個很容易犯的誤會:說 AI 把垃圾變成「強 hook」,其實高估了那件事。
社交平台的顯示位就只有那幾行。它不要求你寫得好,它只要求那幾行有東西、句子完整、看起來像一則貼文。門檻不是「強」,門檻是「有」。
看實際勝出的內容就知道:低摩擦的勵志金句,加幾個 emoji,結尾導流到 LINE。開頭寫「名單一定要花錢買‼️」。那不是技藝,那甚至不是 hook。那只是把顯示位填滿。
所以 AI 提供的不是強 hook,是把那個位廉價地填滿的能力。而這件事對不同的人效果完全不對稱。
庸俗內容的瓶頸本來就是這一層。有東西想講但寫得差,或者根本沒東西講、連幾行都湊不出。AI 一鏟走這層,它立刻飛起來。
密度高的內容,瓶頸從來不在這一層。所以 AI 在分發這條軸上什麼都給不了,反而要倒扣——第四節那股往大眾推的力,是你要花時間頂住的稅。
也就是說,AI 是一種累退補貼:得益跟你有多少東西想講成反比。最沒有東西講的人拿到最多。而因為門檻本來就低,這筆補貼幾乎不用成本就領得到。
再往下一層。能把幾行字湊得像樣,以前是一個很弱但不是零的訊號,起碼證明有人肯坐下來寫。現在它零成本,所以不再攜帶任何資訊。但平台的排序函數仍然把它當入場條件在讀。
排序函數現在在量一個已經沒有代理關係的變數。
九、那還有沒有人看
寫到這裡,真正的問題浮出來:如果刻意不做去 AI 味加工,只顧內容,是不是就過不了分發,也不會有人看和轉發。
第一半,我認為前提不成立。去 AI 味從來不是任何一道閘。
社交平台的排序不讀 AI 味,讀的是互動形狀。觸及的問題在那裡,洗不洗稿都一樣。AI 偵測器主要是編輯部和學校在用,跟一般作者的分發無關。而真正的 AI 答案層,完全不罰 AI 味——我自己有實證:搜尋引擎的 AI 摘要正確地把內容歸給我的筆名;另一個平台的 AI 助手判斷我的文章是人手寫的,還主動叫發問的人不要在該平台分享,去別的地方看。
所以拒絕洗稿,沒有付出過分發代價。那個成本是想像出來的。
真正的問題是另一件事。
我用自己一篇文章的完整標題去搜尋——一個只有讀過那篇文的人才會打出來的字串。搜尋引擎的 AI 摘要準確地講出了那篇文的論點,也把它歸給我的筆名。但它標示的來源,是那篇文貼在某個社群平台上的版本,不是我的網站。
另一次也一樣。來源換了一個,我的網域一樣沒有出現。
共通點不是「來源標錯了」。是我的網域從來沒有進過那個位置。
AI 讀了它、記住了它、用它回答了別人,然後沒有給那個人一條走回來的路。
內容被分發了。分發給機器,分發給平台,就是沒有分發到我這裡。
這後面還有一整套機制——索引和動態牆是兩個獨立的開關,壓制只碰其中一個,另一個繼續替平台累積權重。那是另一篇文章的題目,這裡先按下不表。
第二半,要把「看」和「轉發」分開。
看不是問題。網站數據很清楚:進到第一章的人,八九成會讀完整本;核心文章的跳出率不到一成。願意看的人,看得完。
轉發才是死位,而原因跟品質無關。
轉發是一個社交動作。你把一樣東西轉出去,等於替收件人的時間做擔保。轉一條三分鐘的短片零成本;轉一篇要人坐下來半個鐘、而且結論令人不舒服的結構分析,你要背起對方那半個鐘。很少人願意背。
再加上種子節點問題:如果你最初的社交圖已經鎖死在某幾個圈子裡面,即使有人肯轉,也轉不出那個連通分量。
十、剩下兩個機制
所以直說:這類內容不會傳播,而且大概率永遠不會。不要等轉捩點。
它走的是另外兩個機制。
堆積。 索引、開放條款、不封爬蟲。這些東西今天沒有回報,但它們在那裡。
不過上一節那件事,給堆積加了一個條件:只有當完整的那一份在你自己的網域上,堆積才會複利。如果同一段文字在一個權重高得多的平台上也有一份,你累積的是那個平台的資產,不是你的。堆積不是「發了就算」,是要確保標準版本只有一個地方。
事後被找到。 一個判斷寫下來,標了日期,公開可查,然後等現實走過來。當它被驗證的時候,人是回頭找你的。這是唯一一種不需要演算法配合的分發。
書也屬於後者。書不需要每篇搏觸及,書是等人幾年後撞到。
要老實補一句:這兩個機制的回報週期以年計,而且不保證兌現。
所以要決定的不是怎樣過分發,而是願不願意接受一套回報極慢、可能落空的經濟。
我把整條推理攤開,是因為我自己也還在算這條數。
而如果連這篇文章都沒有人轉,那它剛好就是自己的第一個資料點。